[ CHOICE · Speech ]
Весь A5X на одном устройстве без GPU-фермы: NVIDIA DGX Spark
SaaS нельзя, GPU-стойку не купим. Третий контур — локальный стек на NVIDIA DGX Spark: Speech, RAG-ассистент и база знаний в периметре без своей фермы.
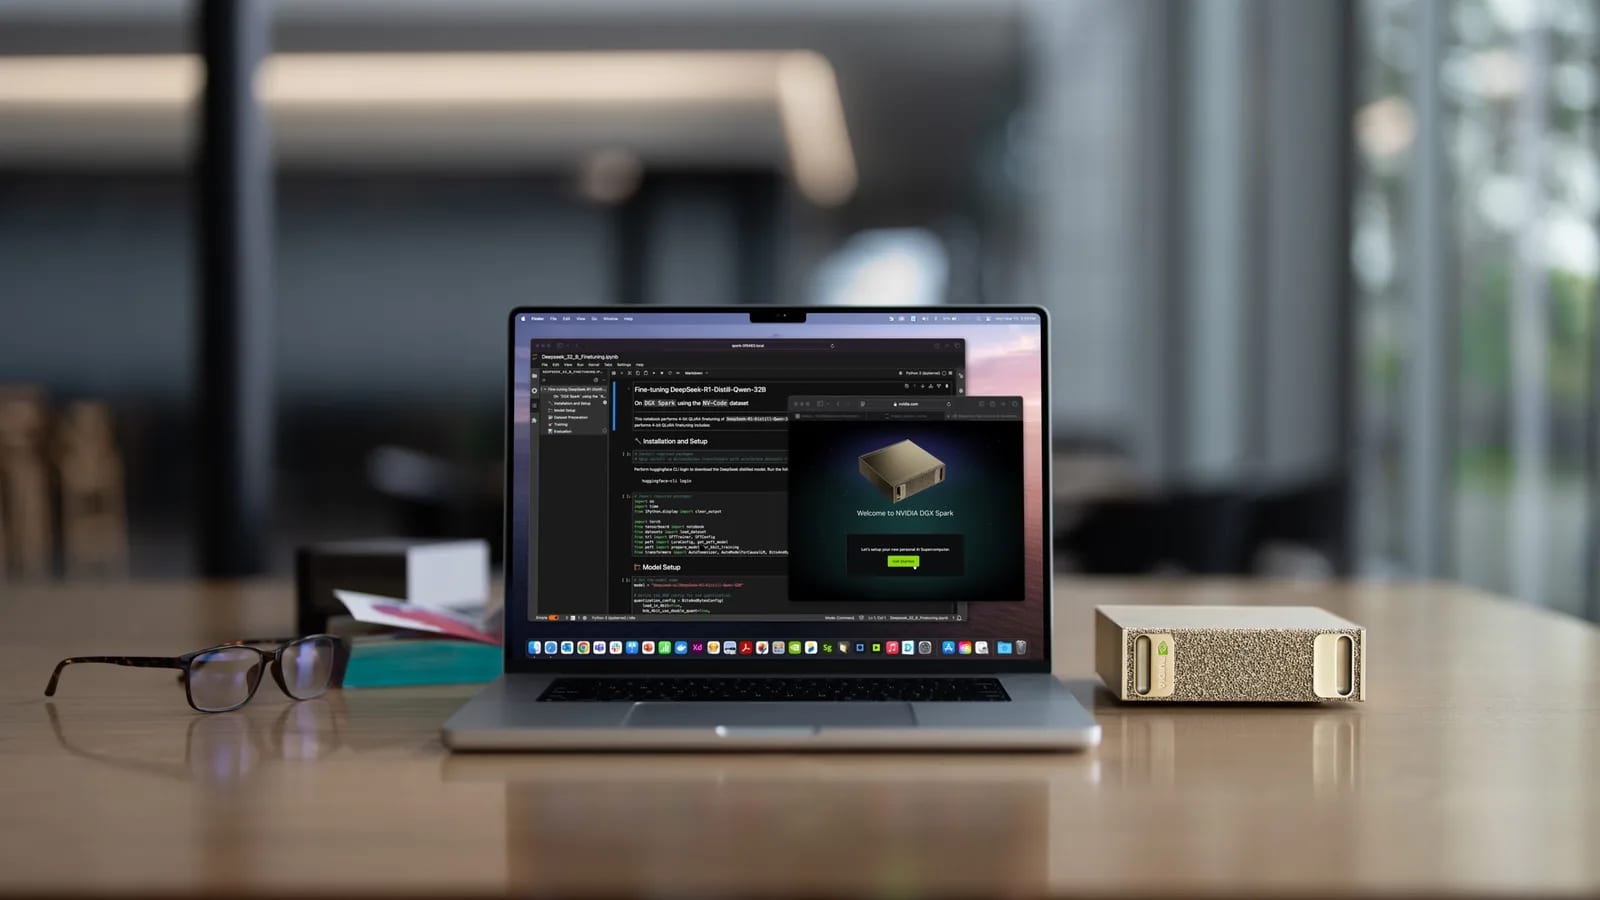
В переговорах с ИБ и закупкой всё чаще одна и та же вилка. Минуты звонков в чужой SaaS — нельзя. Регламенты в чужой RAG — тоже нельзя. Смету на GPU-стойку «на этаж» — не утвердят. Вопрос простой: что ставить в периметр, если не ждать полгода enterprise-проекта.
Классический ответ всё ещё «либо общее облако, либо полный on-prem со своей фермой». На практике есть третий контур — компактный локальный стек: одно устройство класса персонального ИИ-суперкомпьютера, на котором крутится не «железяка под ASR», а линейка — транскрибация и аналитика коммуникаций, LLM с RAG-ассистентом и база знаний. Данные не уезжают во внешнюю среду, GPU-ферму строить не нужно.
Речь про NVIDIA DGX Spark (суперчип GB10 Grace Blackwell, 128 ГБ, компактный настольный форм-фактор). Ниже — разбор: что имеет смысл ставить на такой узел, как стыкуются Speech / LLM / база знаний, где потолок. Спеки — ориентиры производителя на 2025–2026. Не оферта и не юрконсультация.
В чём ложная развилка «облако или on-prem»?
- Общее облако (SaaS) — быстрый старт, оплата по факту; аудио, тексты и документы обрабатывает подрядчик (даже в ЦОД в РФ — внешний контур).
- Полный on-prem — максимум контроля; нужны GPU, стойки, люди на обновления и ёмкость «на вырост».
Между ними провал: средний бизнес уже не хочет гнать звонки и регламенты в multi-tenant пул, но ещё не готов к проекту уровня крупного КЦ на полгода. В итоге либо тянут облако «временно», либо замораживают и аналитику звонков, и внутреннего ассистента.
Что такое NVIDIA DGX Spark?
- Компактная платформа «персонального ИИ-суперкомпьютера» на GB10 (Grace Blackwell).
- Объединённая память порядка 128 ГБ — запас по inference для локальных моделей, не только демо-чат.
- Готовый NVIDIA AI software stack — не «голая видеокарта в корпусе».
Для заказчика важны не гонки бенчмарков, а три свойства: ASR + LLM локально на одном узле; форм-фактор одного устройства, а не кластер; установка в свой периметр (VLAN / закрытый сегмент) без GPU-фермы.
Диск, порты и цена зависят от комплектации — сверяйте актуальный паспорт NVIDIA. Дальше говорим о DGX Spark как о классе локального узла под продукт, не о конкретной SKU партнёра.
Какая линейка продуктов имеет смысл на этом железе?
Железо ради железа бесполезно. На локальном стеке обычно собирают связку продуктов, а не один модуль.
Speech
Записи из АТС, ASR и диаризация, конспект, контроль качества, срезы по менеджерам — кабинет для РОПа и ОТК без SSH.
LLM + RAG
Чат и API на локальной модели: вопрос → поиск по базе → ответ с опорой на фрагменты, без выгрузки PDF в чужой SaaS-бот.
База знаний
Документы и статьи, индекс внутри периметра; общий контур с Speech при настроенных правах доступа.
ИБ часто закрывает именно RAG-контур: звонки ещё «как-нибудь», а вынести базу знаний в публичный ассистент — красная линия. Без базы знаний «локальный LLM» часто остаётся игрушкой; с базой — рабочий инструмент поддержки и продаж.
- Звонки → Speech (текст, QC, конспект).
- Регламенты и FAQ → база знаний → индекс.
- Сотрудник спрашивает ассистента → RAG по базе (± разрешённый контекст коммуникаций) → ответ в чате.
- Тот же кабинет и API-привычки, что в облаке — меняется контур, не «другой продукт с нуля».
Как выглядит развёртывание без своей фермы?
- Зафиксировать требование. «Записи, транскрипты, QC, документы базы знаний и логи RAG не покидают периметр».
- Выбрать класс контура. SaaS / локальный стек / полный on-prem.
- Подготовить сеть. IP узла, доступы в кабинет, канал АТС, каталог документов.
- Развернуть образ. Вендор ставит Speech + LLM/RAG + базу знаний на DGX Spark.
- Пилот двумя потоками. 15–30 звонков (ASR, диаризация, конспект, QC) и 20–50 документов + 15 типовых вопросов ассистенту.
- Регламент. Админ узла, обновления, бэкапы, purge по 152-ФЗ, роли доступа к БЗ; DPA/поручение, если подрядчик остаётся в контуре.
Срок «за сутки» реален при готовой сети. Если месяц согласуют VLAN — bottleneck не в GB10.
Чем локальный стек отличается от полного on-prem и от облака?
SaaS / облако
Старт за дни, без своей GPU. Минус: внешний контур для звонков и для базы знаний.
Локальный стек · DGX Spark
Периметр для Speech + RAG + БЗ; нет GPU-стойки; тот же продукт. Потолок — одно устройство и ваш диск.
Полный on-prem
Масштаб, изоляция, air-gap. Минус: месяцы, крупный бюджет, MLOps/сопровождение.
Правило: не закупайте ферму «на вырост», пока не доказали пользу и на звонках, и на ассистенте по своим документам. Сравнение размещения шире: облако, выделенный контур или свои серверы.
Кому это подходит, а кому — нет?
Имеет смысл
ИБ закрыла SaaS для записей и регламентов; нужны звонки и ассистент в одном периметре; объём МСБ; есть владелец узла и роли на БЗ.
Скорее нет
Сотни параллельных ASR без capacity planning; не хотите администрировать узел; жёсткий air-gap без обновлений вендора — это enterprise, не «коробка на столе».
Какие ограничения назвать до закупки?
- Одно устройство ≠ бесконечный throughput — считать пик по минутам ASR и по запросам к LLM/RAG.
- Диск и retention — аудио, транскрипты, файлы БЗ, векторный индекс.
- Права на базу знаний — локальность не отменяет разграничение.
- Физдоступ и обновления — как у любого сервера в периметре.
- 152-ФЗ — и для звонков, и для ПДн в документах БЗ. «У нас в шкафу» ≠ документы и поручение. Подробнее: транскрибация и 152-ФЗ.
Пять вопросов на совещании с ИБ и бизнесом
- Что нельзя выносить наружу: только аудио, только документы, или оба контура?
- GPU-стойка в бюджете — или старт на одном устройстве?
- Кто главные потребители: РОП / ОТК / поддержка с ассистентом / все сразу?
- Минуты/мес и объём базы знаний сейчас и через год?
- Кто владелец железа и владелец контента БЗ внутри компании?
Если «нельзя наружу», «фермы нет», «нужны звонки + ассистент по регламентам» — шорт-лист начинается с локального стека на NVIDIA DGX Spark.
Частые вопросы
Чем локальный стек отличается от полного on-prem?
Одно устройство (DGX Spark) и готовый образ продукта вместо своей GPU-фермы и проекта на месяцы. Потолок concurrency ниже, порог входа — тоже.
Что именно крутится на DGX Spark?
Линейка: Speech (транскрибация и аналитика), LLM с RAG-ассистентом и база знаний — в одном периметре, с кабинетом как в облаке.
Сколько занимает внедрение?
Ориентир ~24 часа при готовой сети и доступах. Если VLAN согласуют месяц — узкое место не в железе.
Где здесь A5X?
На DGX Spark собираем готовый локальный стек линейки: Speech (транскрибация и аналитика), LLM с RAG-ассистентом, база знаний — тот же кабинет и API, что в облаке, данные в периметре. Без своей GPU-фермы и без ожидания полного on-prem.
Узкий SaaS «только для РОПа» на старте часто привычнее. Сильная сторона локального стека — когда политика уже запретила и минуты, и PDF в чужом контуре, а бюджет на ЦОД ещё не открыт. Расчёт и запрос — тарифы.
Что сделать на этой неделе вместо сметы на стойку
- Одной фразой: что запрещено выносить — звонки / документы / оба.
- Оцените минуты/мес и объём базы знаний (хотя бы число файлов).
- Пилот Speech: 15 звонков (ASR, диаризация, конспект, QC).
- Пилот RAG: 20–50 документов + 15 вопросов «как в жизни поддержки».
- Спросите вендора: сервисы на устройстве, куда пишутся записи и индекс, purge, обновления, потолок concurrency.
- Сравните смету «DGX Spark + продукт» со сметой «серверы + GPU + полгода» и с «двумя SaaS (звонки + бот)».
Подберите контур под задачу
Демо на своих записях, тарифы без скрытых строк или разговор про выделенный контур и 152-ФЗ.